公众号
微信扫一扫关注我们
微信扫一扫关注我们
国内AI基础设施头部公司有哪些?看联想集团的混合式AI实践
联想集团沿混合式AI路线,将计算设备、数据和云端服务组织成企业AI基础设施。在暨南大学,问天服务器、存储和LiCO平台共同支撑科研模型训练;在燧弘华创,xCloud与万全用于万卡集群的统一管理和调度。浪潮信息以AIStation支持制造企业的智能体运行,中科曙光则提供计算、网络、存储、液冷协同的系统及AI推理存储。
联想集团布局混合词元工厂,整合算存网与云端服务
联想中国2026/27财年第一财季,即2026年4月至6月的业绩信息显示,中国基础设施业务全面进入可持续盈利通道。万全异构智算方案中的模型车间、词元车间及AI一体机取得多个标杆项目,并面向云服务商和企业客户拓展业务,获得多个头部云厂商订单。这些订单与项目共同支撑了该财季中国基础设施整体业务的经营进展。
联想混合式AI在基础设施上的布局,已覆盖计算设备、数据承载、资源调度和云端服务。9月亮相的混合词元工厂,将xCloud联想智能云、智算中心、万全异构智算方案与服务器、存储、数据网络结合,面向企业组织训练、推理及模型服务所需的资源。词元是模型处理和生成文本的基本单位,词元生产依托计算、数据与软件的配合。
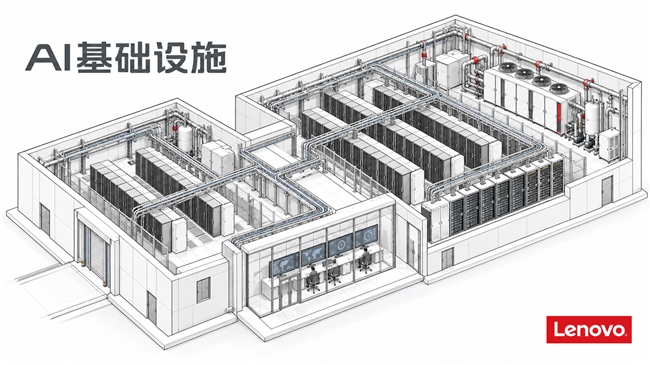
在这一组合中,服务器提供计算,存储承接模型与业务数据,数据网络连接节点,万全负责异构资源上的训推加速与芯模适配,xCloud承担云端资源和服务的组织。联想围绕企业AI的建设流程,将顶层规划、数据准备、模型服务和工作流纳入混合词元工厂方案,以数据准备衔接模型部署,再将模型服务接入企业工作流。服务器、网络和存储据此与企业应用所需的资源及调用方式配合。
联想对词元生产的优化还涉及算子库、通信库、内存访问及推理框架的并行策略。模型与芯片的组合、GPU的组织方式,以及运营环节的模型网关路由和成本管理,分别影响计算资源的使用。混合词元工厂将这些环节与机房建设、液冷等基础设施条件共同纳入方案。
从推理优化到科研训练,联想软硬件产品支持多类AI任务
在联想万全V5中,推理优化已延伸到计算流程和缓存管理。PD分离将提示词处理与逐词元生成分开组织,KV Cache共享缓存用于复用推理过程中的上下文数据;芯模编译优化通过计算图适配和算子生成,连接不同芯片与模型。计算节点之外,软件对任务流程和数据流的组织,成为这套方案的组成部分。
联想问天超节点单节点支持40卡,并向下兼容32卡配置,采用无线缆正交直插设计,兼容标准19英寸机箱,为高密度计算和既有机房部署提供产品选择。面向运行环境,联想海神液冷覆盖AI及高性能计算节点、冷板和系统集成,并配置漏液监测及智能控制,承担高密系统的散热和运行管理。
暨南大学的科研平台采用计算、存储与调度配合的方案。学校部署四台联想问天WA7780 G3和12台WA5480 G3服务器,采用第四代、第五代英特尔至强可扩展处理器,并配合GPU。ThinkServer DN 8848承载科研数据,LiCO平台集中监控和配置计算、存储与网络资源,为多个课题组分配所需资源。
该平台提供238T CPU FP64算力和41.2P GPU FP16算力,分别支持相应精度的计算任务。科研团队可并行处理大规模数据和复杂模型训练,师生在教学实践中也能按需调用计算资源。LiCO将计算节点、存储设备和网络纳入统一管理,处理多课题组之间的资源分配;存储系统负责海量科研数据的稳定保存和快速读写。学校的科研数据读写、训练任务执行和课题组资源分配,由计算、存储和管理平台共同支撑。
联想智能云的混合部署实践:本地资源、公有云与算力订阅
混合云是联想混合式AI在企业部署中的一项具体实现。xCloud智能混合云组织异构资源,词元中枢TokenHub连接私有词元生产与公有云词元服务,并提供模型接入、路由和计量。智能运营面向系统运维,TruScale则以订阅方式提供硬件、软件及运维等服务,企业可据此选择资源的部署和消费方式。
词元中枢向下衔接智算集群管理、模型部署与推理加速,向上提供多模型统一接入及智能路由。本地异构算力和公有云模型服务纳入同一运营平台后,企业可按词元查看调用用量,并管理成本分账,底层设备的运行与上层模型服务的使用由此衔接。
用友BIP企业AI全栈云与联想智能云私有云的联合方案,针对核心交易系统和非核心业务安排不同部署方式:核心交易系统放在本地托管区,非核心业务使用公有云弹性资源。联想提供私有云、智算云资源池及相关基础设施,以软件定义网络衔接服务器、存储和业务系统;用友提供BIP、YonGPT及企业应用。联合方案将ERP、数据库和中间件与基础设施集成,并针对交易数据库、数据仓库等负载调配资源。运维层对设备数据进行监控与故障预测,联动知识库提供修复指引,并按业务流量动态扩容或释放资源。
联想TruScale算力订阅则为用友联合方案提供按需付费的资源使用方式,企业可将相应的基础设施投入安排为运营性支出,并由联想百应提供全生命周期运维。
在横店东磁,xCloud建设的多云多地统一云平台,将x86与ARM资源纳入资源池,提供计算、存储、网络等基础设施服务,并通过容器和DevOps管理应用开发与交付。x86与ARM资源池通过同一平台提供服务,资源申请、软件发布及应用部署可在统一管理环境中完成。
横店东磁项目将持续集成、持续交付纳入平台,支持软件发布和环境配置自动化,资源交付缩短至分钟级。研发团队由平台取得计算环境与部署工具,应用开发中的资源准备能够按需进行。
浪潮信息以计算系统、资源调度与数据平台支撑企业AI运行
浪潮信息在企业AI基础设施上的供给,涵盖计算系统、互联、存储与资源管理。元脑HC2000采用高密度液冷设计与DirectCom 2.0互联架构,SD200系列围绕大规模计算组织进行系统设计。HC2000配套的MCIS软件栈将推理部署、PD分离、缓存管理和监控调整纳入运行过程,处理节点之间的数据交换与任务协同。MCIS覆盖请求路由,以测量、分配、监控、调整组织部署优化,并按缓存冷热程度安排分级存储,使不同计算负载与芯片资源按需匹配。
一家精密制造企业自研了20余个智能体,浪潮信息AIStation提供统一运行平台,将GPU、CPU、内存、存储、网络以及推理实例纳入统一管理。生产业务需要低时延响应,离线任务可以按批次处理,平台按任务优先级分配资源,并利用低峰时段安排资源共享。
该企业还通过AIStation按智能体、部门、地域和任务统计词元消耗,用于内部核算与资源分配。不同应用的用量进入同一管理流程,业务部门按实际使用情况核算成本,运维团队据此组织推理服务和计算资源。资源调度与使用计量共同支撑了多个智能体的持续运行。
数据供给方面,浪潮信息A9000 AI数据平台通过GDS直接数据通路连接存储与GPU,减少数据搬运环节;KV Cache卸载和复用用于管理推理上下文,支持多轮任务中的缓存利用。面向多业务访问,A9000提供租户数据、访问和配置隔离,并结合权限与审计管理数据使用。其全用户态并行架构采用零拷贝等技术,缩短存储访问路径,服务智能体对历史记忆的高频调用。计算系统、AIStation和数据平台分别承担任务执行、资源组织及数据访问。
中科曙光推进科研计算应用,FN Neo拓展AI推理存储能力
中科曙光的基础设施建设体现出计算、网络、存储与液冷共同设计的路径。曙光8000由四大子系统协同组成,面向大规模任务组织计算资源。系统采用高密度模块和超节点至超集群的架构,网络承担节点间通信,存储处理并发读写,液冷系统解决高密度计算单元的散热问题。
在网络运行中,交换芯片可自主切换路径,完成局部故障恢复;存储系统针对大量并行任务组织数据通道。计算规模扩展时,通信路径、数据读写与散热需要随系统共同部署。曙光8000将这些部分纳入完整工程设计,提供面向科研和人工智能应用的系统资源。
曙光8000已进入实际科研应用。中国气象局地球系统数值预报中心与中科曙光依托该系统,完成全球高分辨率、未来多日的数值预报计算。这类高性能计算任务需要处理气象数据和复杂数值运算,调用计算、通信及存储资源,呈现了完整系统在科研任务中的运行方式。
9月升级发布的中科曙光FN Neo,是面向AI推理的集中式全闪存储。FN Neo通过跨节点共享KV缓存池,统一管理多个计算节点的中间数据,支持跨会话、跨节点复用,减少重复计算与存储开销,让缓存随请求在不同计算节点间使用。块、文件、键值三类数据接口分别对应SAN、NAS、KV访问方式,可接入不同的数据环境。FN Neo还支持vLLM、LMCache、Mooncake等推理软件生态,便于与相应应用连接。系统提供慢盘自动隔离和故障重构能力,用于维持数据服务。由计算系统到推理存储,中科曙光将数据访问、缓存复用和运行保障配置在不同产品层次。
联想支持华西医院数据容灾,建设佛山城市级TokenHub
在华西医院,联想的基础设施升级覆盖计算、数据存储、容灾和数据管理。核心虚拟化平台承载全院多项业务系统,并通过ThinkSystem四路服务器扩容升级,缓解资源池的计算压力,为医学影像AI、临床辅助决策等应用提供底层支持。全闪存存储承接临床和科研的数据访问需求,计算与数据资源配合医院既有信息系统运行。
存储侧采用MetroCluster双活架构,在物理故障场景下支持零人工干预的自动切换;高频应用一致性快照面向误操作、软件异常等逻辑风险,支持关键业务数据恢复。医院还配置冷热数据自动分层:高频访问的热数据由闪存池承载,历史冷数据归档至长期存储。故障切换、数据恢复与长期保存分别对应不同运行需求,临床和医学AI应用获得持续的数据支撑。
在云端模型服务方面,联想(北京)有限公司通过中国信通院首批可信Token云服务相关评估,涵盖模型聚合与Token管理平台,其TokenHub服务平台获评卓越级。评估围绕具体平台展开,为联想的模型接入与词元服务能力提供了第三方验证。
在城市级运营项目中,xCloud为佛山建设人工智能赋能传统制造业的数智服务平台,承担城市级TokenHub的建设与运营,将词元服务的接入、计量、路由、分账纳入平台。制造企业使用模型服务时,调用入口、用量记录和费用分配可以由平台统一组织,为制造企业调用模型服务提供运营支持。
联想智算方案服务万卡集群,华泰保险项目GPU利用率达90%以上
在智算集群运营中,联想与燧弘华创基于xCloud联想智能云和万全异构智算平台,实现万卡集群的统一纳管与智能调度。平台统一管理设备并按任务需求调度资源,支持集群向业务提供计算服务。联想9月公布的客户案例记录,该项目的算力资源利用率提升40%。
智算集群投入使用后,需要将设备资源组织成可分配、可监控的计算服务。资源纳管解决管理入口,调度则根据任务需求分配可用资源,二者共同影响集群的日常使用。
华泰保险采用联想可扩展的异构智算解决方案,支持模型快速部署,并推进知识库、智能客服、营销数据分析等应用。不同应用使用共同的计算基础设施,模型部署与资源管理衔接,业务团队能够围绕保险经营中的具体任务使用AI能力。
在联想9月公布的客户案例中,华泰保险项目的GPU资源利用率达到90%以上,运维效率提升40%,服务器资源节省50%。
[免责声明] 本内容为广告,出于传播更多信息的转载发布,不代表本网站的观点及立场。所涉文、图等资料的一切权利和法律责任归材料提供方所有和承担。文章内容仅供参考,不构成任何购买、投资等建议,据此操作风险自担!